一、为什么单节点代理容易在长连接中猝死
单节点连接再快,只要遇到机房网络抖动、母机维护或运营商短暂重路由,本地 TCP 连接就会瞬间掐断。
对于刷网页,刷新一下可能感知不强。
但如果你正在跑大文件断点续传、远程代码编译、或者挂着海外实时金融行情推送,单节点断流就是灾难。
很多人的解决方式是手动去托盘列表里点右键切节点。这种被动应对不仅慢,而且中断已经发生。
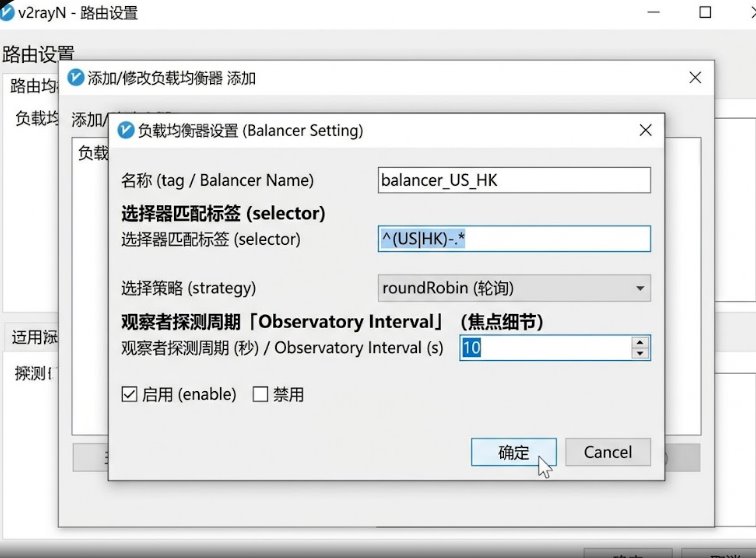
v2rayN 底层依赖的 Xray-core 本身就原生集成了强大的 Balancer(负载均衡器)与 Observatory(状态观察者)。它可以在后台以极低开销对一组指定节点持续发送健康心跳包,在毫秒级内自动把断线节点从可用池中拉黑,同时把新建请求按照轮询(RoundRobin)或随机(Random)分配到健康节点上。
二、Balancer 核心工作逻辑解析
在配置之前,必须搞清楚三个核心概念的关联:
Outbound Tag(出站标签):这是你节点池的标识。例如给 3 个香港节点分别打上 `hk-01`、`hk-02`、`hk-03` 的标签。
Observatory(观察者):负责巡检的探针。每隔 10 秒向指定的轻量目标(如 `https://www.google.com/generate_204`)发送探测,记录各节点的握手成功率与真实 RTT。
Balancer 调度策略:
- `roundRobin`:严格轮流派遣。请求 1 走节点 A,请求 2 走节点 B,均匀分散流量。
- `random`:完全随机挑选健康节点,适合带宽分布不均的多机房场景。
- `leastPing`:优先把流量调度给当前探测延迟最低的健康节点。
三、从零搭建高可用负载均衡池
第一步:规范出站节点标签命名
打开 v2rayN。
挑选 3 到 5 个同一地区、同协议的稳定节点(例如同一服务商的 3 个日本节点)。
双击每个节点进入编辑页,将它们的「别名」修改为包含统一前缀的格式:
- `LB-JP-Node1`
- `LB-JP-Node2`
- `LB-JP-Node3`
统一前缀是后续正则匹配的基础,务必保持拼写一致。
第二步:在高级路由中创建 Balancer 规则
点击顶部菜单 「设置」 -> 「路由设置」。
切换到顶部的 「高级功能」 选项卡,找到左下侧的 「负载均衡 (Balancer)」 列表。
点击「添加」,弹出配置表单:
- 标签 (Tag):自定义一个名称,例如 `Balancer-JP`。
- 选择器 (Selector):填写用于匹配节点的正则前缀,输入 `^LB-JP-`。只要节点别名以此开头,就会被自动吸纳进调度池。
- 策略 (Strategy):下拉选择 `roundRobin` 或 `leastPing`。推荐选择 `leastPing`,这样会自动规避偶发高延迟的节点。
在下方的「观察者配置」中:
- 探测地址:填入 `https://cp.cloudflare.com/generate_204`
- 探测周期:设置为 `10s`
- 超时阈值:设置为 `3000ms`
点击确定保存。
第三步:将路由规则流向绑定至 Balancer
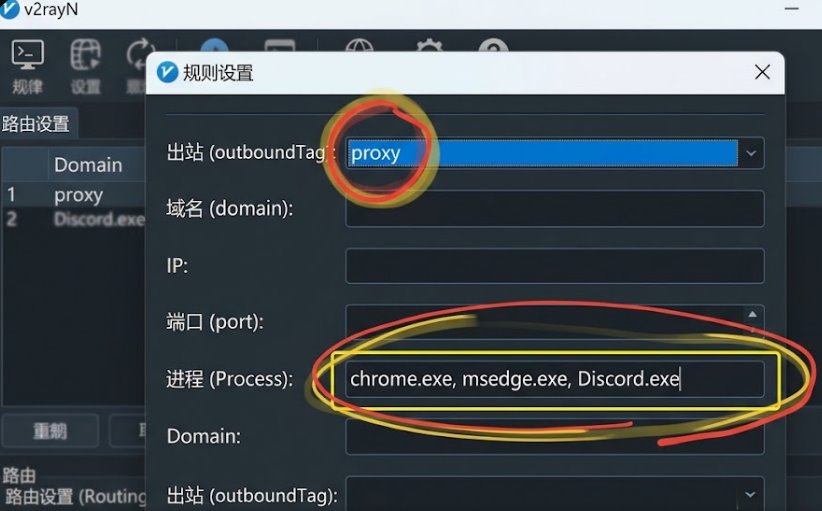
光有负载均衡器还不够,必须指定哪些流量流向它:
回到「路由设置」主界面的规则列表。
新增一条路由规则:
- 将目标规则设为代理(如代理海外网站、或常规 Rule 路由)。
- 在「出站标签 (Outbound Tag)」下拉菜单中,不要选具体的单个节点,直接选择刚才创建的 `Balancer-JP`。
点击确定,保存并重启 v2rayN 服务。
四、验证与故障模拟测试
想知道负载均衡到底有没有生效,可以做两个简单的验证动作:
查看活跃调度日志:
打开 v2rayN 底部的日志窗口,访问几个不同的国外网站。日志中会清晰打印出出站 tag 在 `LB-JP-Node1` 与 `LB-JP-Node2` 之间交替切换的记录。
拔线故障演练:
故意在节点设置中将 Node1 的端口改成错误端口,等待 10 秒(让观察者探针捕获超时)。
此时刷新网页,流量会在后台毫无停滞地全部走 Node2 和 Node3,网页加载完全无感,彻底告别单点故障。